2025年企业AI落地指南:从数据建模到智能决策的完整路径
过去两年,企业AI落地的叙事正在发生微妙但深刻的转向。当ChatGPT掀起的第一波狂热退去,2025年的CIO们不再关心“能不能用大模型”,而是直面更棘手的课题——如何让AI在复杂的业务场景中稳定产出可量化的商业价值。Gartner的调研显示,超过70%的企业AI项目仍停留在试点阶段,真正跨过“最后一公里”的,往往是那些在数据地基和算法选型上想得更清楚的组织。
被低估的数据建模:AI落地的隐形分水岭
很多团队把精力花在调优模型参数上,却忽略了上游的数据质量与特征工程。我们在服务制造业客户时发现,一个看似简单的设备故障预测场景,数据清洗和时序对齐的工作量占了整个项目周期的60%以上。**数据建模不是“锦上添花”,而是决定AI上限的硬约束**。如果源数据存在偏差或缺失,再先进的智能算法研发成果,在真实环境中也会迅速退化。2025年的趋势是,企业开始将数据建模从“项目步骤”提升为“核心资产”,用数据血缘追踪和自动特征工程工具,让模型迭代速度提升一个数量级。
从“单点智能”到“决策闭环”
解决了数据问题,下一个陷阱是“模型孤岛”。不少企业上了十几个AI应用,但彼此割裂——库存预测模型与销售需求预测模型互不通信,导致供应链的牛鞭效应反而被放大。真正的智能决策,需要打通这些孤立节点。雾遇科技(上海)有限公司在服务零售连锁客户时,将需求预测、动态定价和补货策略整合进同一个决策引擎,通过强化学习让系统自动权衡库存成本与缺货损失,最终将毛利率提升了2.3个百分点。这才是数字化方案输出的价值所在:不是交付一个算法,而是交付一套可进化的决策机制。
要实现这种闭环,企业需要关注三个关键动作:
1. 建立统一的特征仓库,让不同业务线的模型共享同一份“事实”;
2. 引入在线学习机制,让模型随业务环境变化自动调整权重;
3. 设计人类反馈接口,让业务专家能干预异常预测,而非盲目信任黑盒。
落地路径:别追求完美,追求“可用的正确”
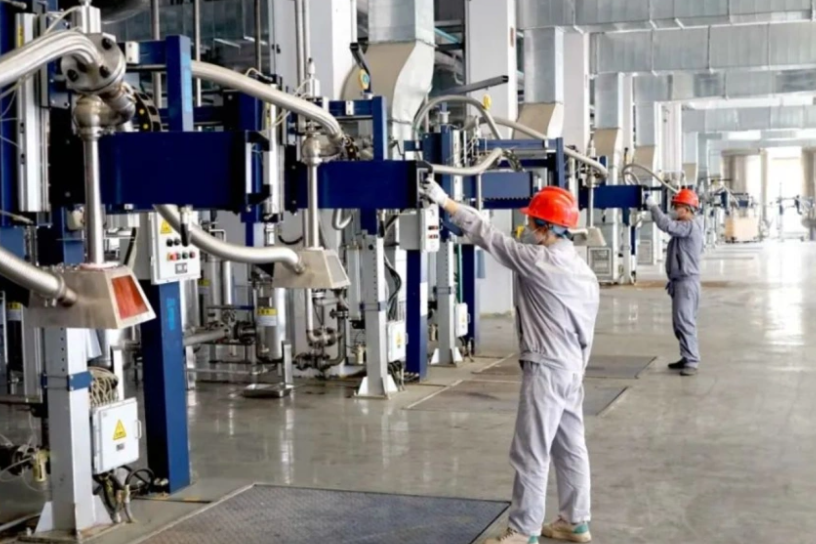
许多企业的失败源于对“精确率”的执念。在制造业良率预测中,一个95%准确率的模型可能因为2%的误报率被产线工人弃用。2025年务实的做法是**以业务约束为导向反推算法设计**——比如在模型损失函数中直接加入误报惩罚项,或者通过主动学习策略,让模型在低置信区间主动向人类专家提问。这些细节,往往比更换更复杂的神经网络结构更能带来实际收益。
雾遇科技(上海)有限公司:人工智能应用开发与智能算法研发团队在项目实践中总结出一条经验——先跑通一个最小业务闭环,再横向扩展。比如,先在单条产线验证质量预测模型,效果稳定后再复制到其他产线。这个过程通常需要6-8周,远比一开始就搭建庞大平台要高效。同时,数据建模分析工作需要与业务部门共同定义“成功指标”,避免技术团队和业务团队对项目目标的理解出现偏差。
站在2025年回望,企业AI的竞争早已从“算力军备竞赛”转向“工程化内功”的比拼。那些能沉下心来打磨数据管线、设计人机协同界面的公司,往往比追逐新模型的同行走得更远。雾遇科技(上海)有限公司的数字化方案输出团队观察到,未来18个月,AI落地将呈现两个清晰趋势:一是领域专用的小模型会替代部分通用大模型,二是决策智能将与业务流程管理系统深度绑定。对于企业决策者而言,现在正是从“试点焦虑”转向“系统规划”的最佳窗口期——不必等到所有条件完美,但必须确保每一步都踩在坚实的数据与逻辑之上。