雾遇科技人工智能应用开发:智能算法研发与数据建模分析技术解析
过去两年,企业级AI项目的失败率一直徘徊在50%以上。问题很少出在算力或框架层面,更多是数据建模分析与业务场景之间的断层——模型在实验室跑出高分,上线后却因数据分布漂移、特征口径不一致而迅速衰减。雾遇科技(上海)有限公司在服务制造、零售、物流等行业的实践中,逐步沉淀出一套从算法研发到数字化方案输出的工程化路径。
智能算法研发:从场景约束出发,而不是从模型出发
算法选型的第一原则是匹配业务约束,而非追求指标上限。以某工业设备故障预测项目为例,产线采样频率高但标注样本稀缺,团队采用半监督学习结合时序特征工程,将误报率控制在3%以内,同时推理延迟压到50ms以下,满足了边缘部署的硬性要求。
在智能算法研发环节,雾遇科技(上海)有限公司通常遵循三条并行路径:
- 监督学习用于标签充足的分类与回归任务,重点在特征筛选与交叉验证策略;
- 无监督与半监督方法应对标注成本高的场景,如异常检测、聚类分群;
- 强化学习用于动态决策优化,例如仓储调度中的路径规划。
每条路径都配套模型可解释性评估,避免"黑箱上线"带来的运维风险。
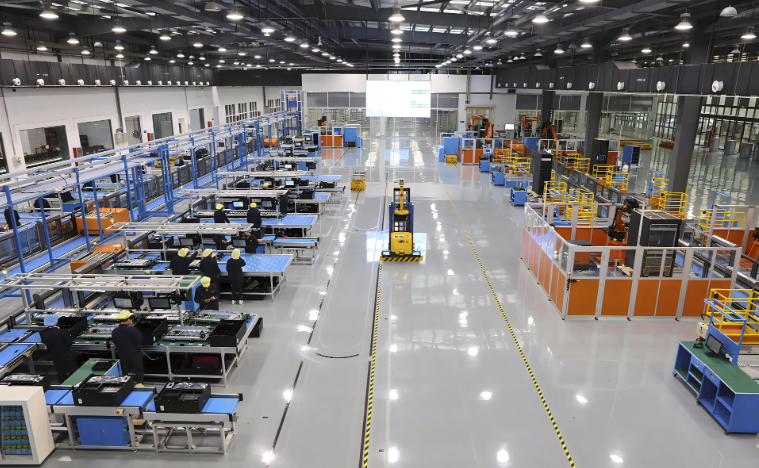
数据建模分析:特征工程决定模型天花板
数据建模分析的核心不在算法调参,而在特征空间的构建质量。实际项目中,原始数据往往存在缺失、噪声和量纲混杂的问题,团队会先做探索性分析(EDA),再通过滑动窗口统计、频域变换、实体嵌入等手段生成衍生特征。某零售客户的需求预测项目中,引入节假日效应编码和天气协变量后,MAPE从18%降至11%。
建模流程上,雾遇科技(上海)有限公司强调可复现性:数据版本、特征定义、超参数配置全部纳入实验管理,确保模型从开发到生产的一致性。
数字化方案输出:让模型真正跑在业务链路上
模型交付只是起点。数字化方案输出涵盖API封装、推理服务部署、监控告警和定期重训练机制。团队通常采用容器化部署配合特征存储(Feature Store),把数据建模分析的成果直接嵌入客户的ERP或MES系统,形成闭环。上线后前三个月设置漂移监测窗口,一旦PSI指标超过阈值即触发模型更新。
从实践来看,项目成功的关键在于早期就让业务方参与指标定义——技术指标(AUC、F1)和业务指标(转化率、停机时长)必须对齐。人工智能应用开发的终点不是一份模型报告,而是一条可持续运转的智能决策链路。
面向未来,雾遇科技(上海)有限公司将持续在智能算法研发与数据建模分析的工程化能力上投入,把数字化方案输出打磨为可复用的方法论,帮助更多企业在真实业务约束下拿到可量化的AI收益。